Die erste Demo einer Dokumentenextraktion mit einem Sprachmodell ist fast immer beeindruckend. Man gibt einen Vertrag hinein und bekommt Parteien, Laufzeit, Beträge und Kündigungsfristen sauber als Daten zurück. Nach einem Nachmittag wirkt das Problem gelöst.
Es ist es nicht. Die Extraktion ist der einfache Teil. Schwierig ist, das Gelesene im Zusammenhang zu modellieren: Was gehört zusammen, was ersetzt was, was gilt ab wann – und was widerspricht sich?
Die echte Welt widerspricht sich
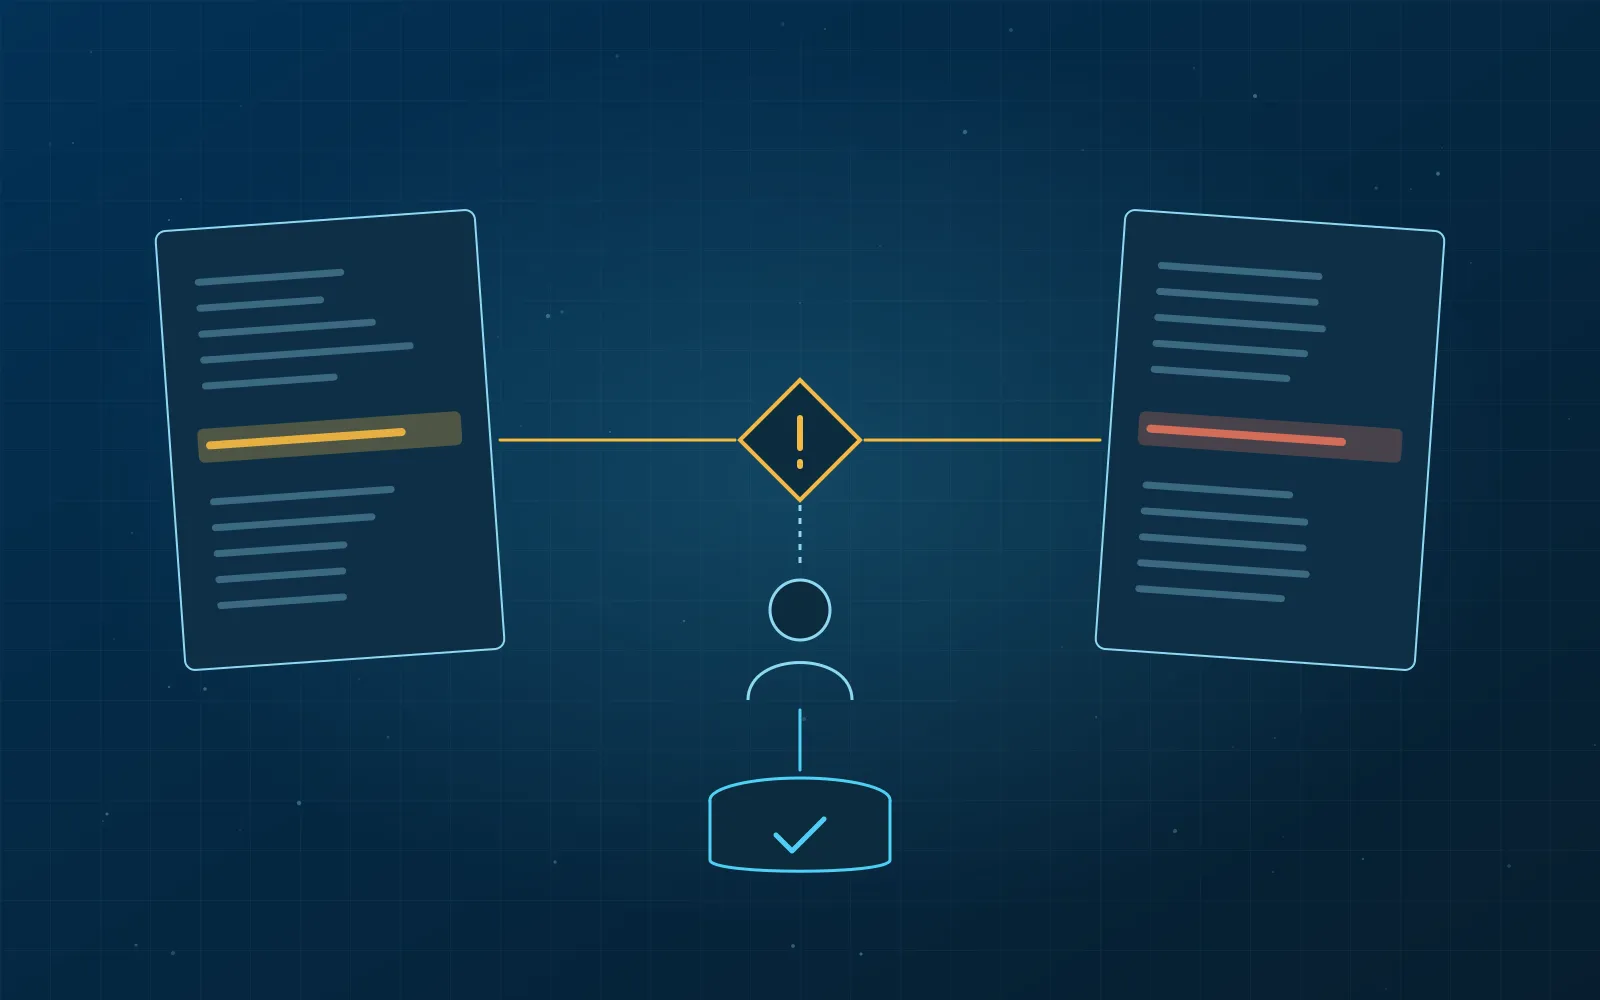
In echten Dokumentenbeständen sagen Dokumente Verschiedenes. Der Vertrag nennt eine Laufzeit, der Nachtrag eine andere. Die Rechnung weist einen Betrag aus, der nicht zur Bestellung passt. Ein Gutachten von 2021 und eines von 2023 kommen zu unterschiedlichen Werten. Manchmal widerspricht sich sogar ein einzelnes Dokument – im Text steht etwas anderes als in der Tabelle.
Ein Sprachmodell löst solche Widersprüche still auf. Es wählt eine Antwort, meist eine plausible, und präsentiert sie mit derselben Sicherheit wie alles andere. Genau das ist das Risiko: nicht der offensichtliche Fehler, sondern die glaubwürdige falsche Antwort.
Embeddings helfen beim Finden, nicht beim Entscheiden
Retrieval mit Embeddings findet relevante Stellen. Ob zwei gefundene Stellen dasselbe meinen, einander ergänzen oder einander widersprechen, beantwortet es nicht. Dafür braucht es ein Modell der Domäne: Was ist ein Nachtrag, was ersetzt er, welches Dokument hat Vorrang, ab wann gilt etwas?
Wie ein verlässliches System damit umgeht
- Jeder Wert mit Quellenangabe: Seite, Abschnitt, Dokument. Ohne Fundstelle kein Wert.
- Regeln vor Vertrauen: deterministische Prüfungen für alles, was sich prüfen lässt – Summen, Fristen, Abhängigkeiten, Vorrang.
- Konflikte als Objekte: Ein Widerspruch wird nicht aufgelöst, sondern gespeichert – mit beiden Quellen.
- Der Mensch entscheidet, das System merkt es sich: Eine Fachperson klärt den Konflikt, und die Entscheidung wird Teil der Daten.
Das klingt nach mehr Arbeit als „Modell fragen, Antwort speichern“. Es ist der Unterschied zwischen einer Demo und einem System, auf dessen Daten man Entscheidungen bauen kann.